Veldra
Deterministic document verification and discrepancy detection for visa workflows
Problem
Manual verification of student visa documents, sponsor cross-referencing, and discrepancy identification is error-prone and time-consuming across disparate records.
Approach
Deterministic document entity extraction, multi-sponsor cross-referencing, and human-in-the-loop discrepancy reporting.
Outcome
Centralizes document checking and surfaces discrepancies to staff before final review, accelerating verification while maintaining strict compliance.
Sponsor Cross-Referencing
Validates relationships and financial capacity across supporting legal documents.
Deterministic Extraction
Extracts entities and verified claims without relying on generative hallucinations.
Mismatch Detection
Surfaces anomalies and discrepancies directly to review staff for verification.
Automated Document Drafting
Drafts explanation letters and discrepancy affidavits from verified audit points.
Upload application documents
Extract entities deterministically
Cross-reference sponsor records
Flag dataset inconsistencies
Generate discrepancy report
Full technical write-up
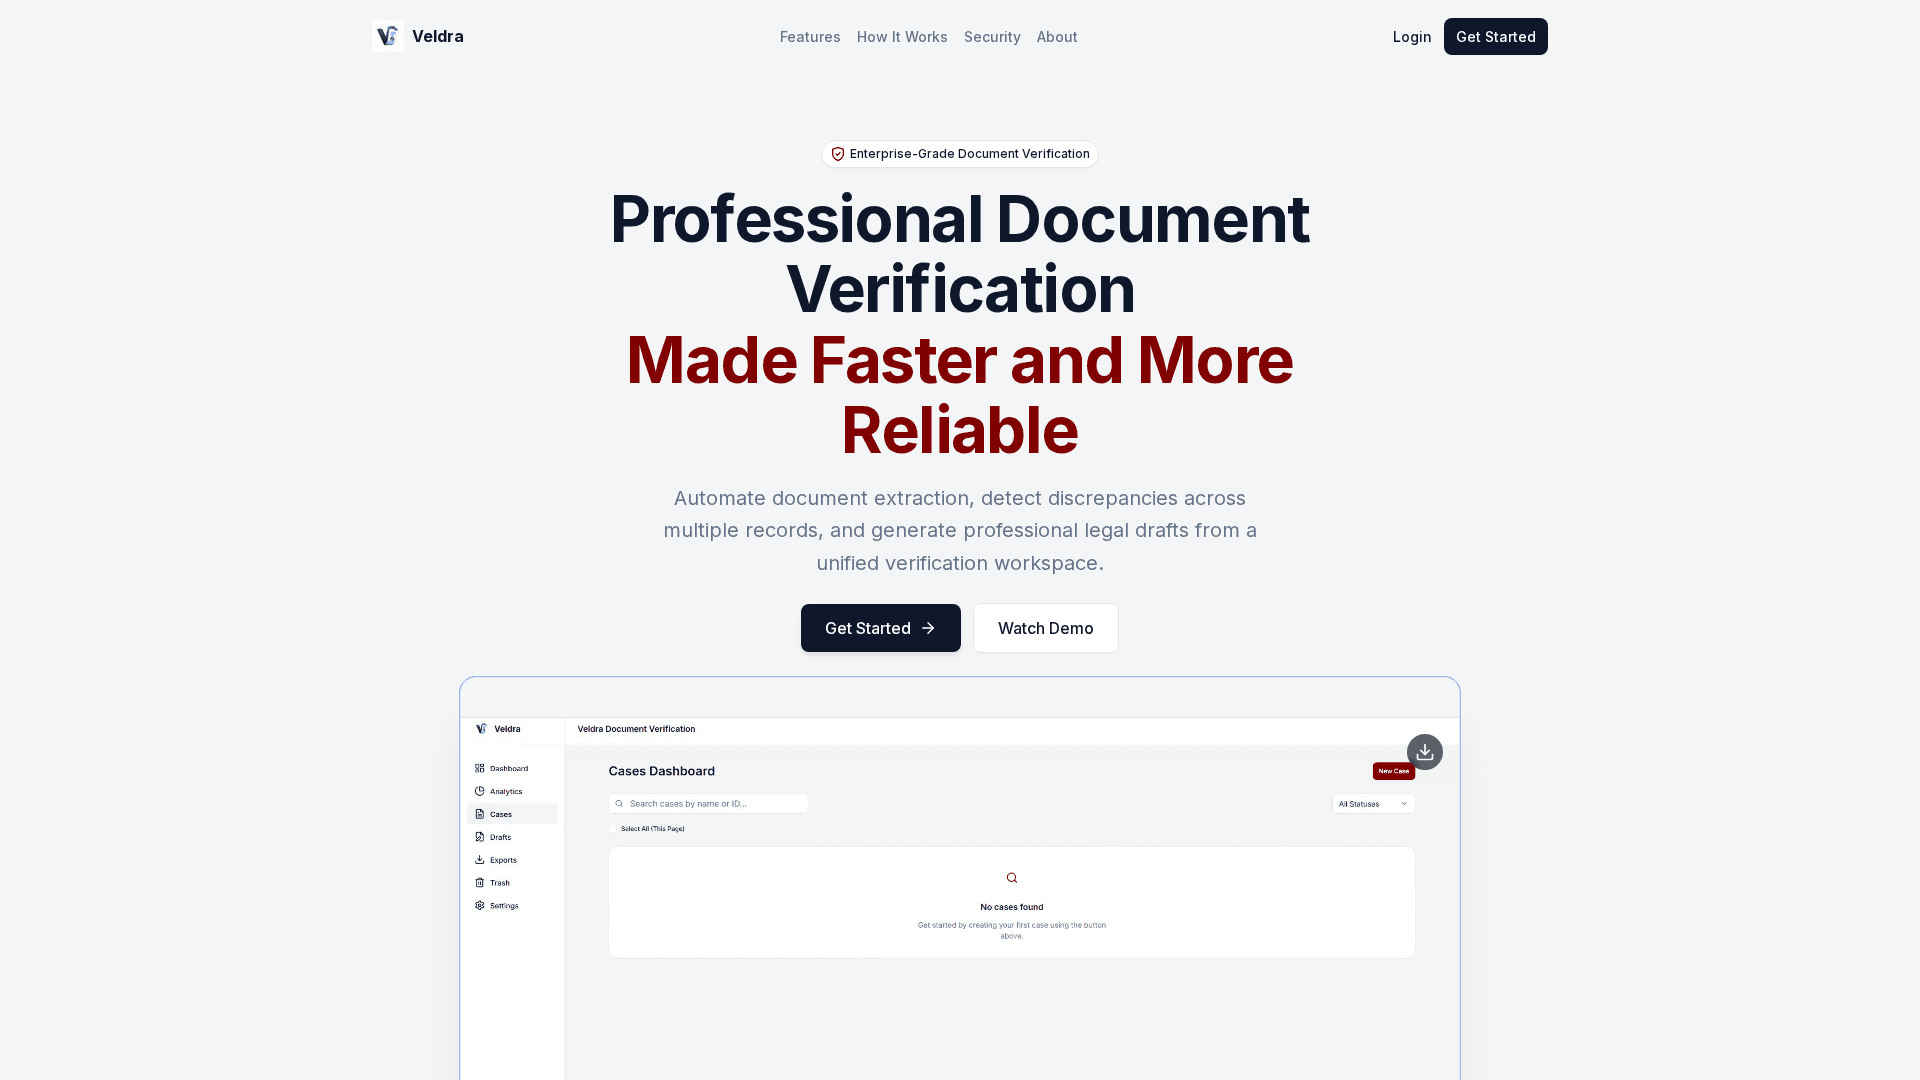
Veldra is an operational document-verification system built to help staff review student visa documentation consistently across applicants, sponsors, and supporting records.
Applicant records span multiple documents, sponsor information needs to remain consistent across financial and legal records, and discrepancies must be surfaced for review rather than manually hunted down.
This project focuses on operational efficiency and deterministic verification, ensuring reliable data extraction and cross-referencing without relying on non-deterministic AI hallucinations for critical visa decisions.
Key architectural modules include multi-sponsor cross-referencing across relatives and financial institutions, human-in-the-loop mismatch handling that flags discrepancies without automated rejection, and automated drafting of discrepancy affidavits and explanation letters.